Shopware-Monitoring auf AWS: Dashboards und Alarme am Praxisbeispiel
Shopware-Monitoring auf AWS am Beispiel PoloProfi: zwei Dashboards, sechs technische Alarme, Bestell- und Zahlungsereignisse sowie Fehleranalyse mit Sentry.
Hinweis
Dieser Beitrag ist der technische Einblick für deine IT: Dashboards, Alarme und Fehleranalyse am konkreten Shop. Den Einstieg für Unternehmer und Shop-Verantwortliche findest du unter Online-Shop-Monitoring: Was du außer der Erreichbarkeit überwachen solltest. Die Hosting-Entscheidung mit Kosten und Zuständigkeiten erklärt Shopware auf AWS hosten.
Bei den meisten Shops, die ich kennenlerne, sieht Monitoring so aus: Der Hoster meldet, dass der Server läuft. Ob der Shop verkauft, zeigt am nächsten Morgen der Bestelleingang.
Das reicht mir nicht. Wenn ich einen Shop betreibe, interessiert mich nicht nur, ob die Maschine antwortet. Mich interessiert, ob Kunden bestellen können.
Am Beispiel PoloProfi zeige ich, welche Signale ich dafür erfasse und wie ich daraus einen Betriebsüberblick aufbaue.
AWS steht für Amazon Web Services. Die Cloud-Plattform stellt unter anderem Server, Datenbanken und Werkzeuge zur Überwachung bereit. Die eingerichteten Alarme überwachen technische Voraussetzungen für einen funktionierenden Shop. Den vollständigen Bestellweg decken sie nicht ab. Welche Prüfungen bereits vorhanden sind und welche noch ausstehen, beschreibe ich weiter unten.
Der Betriebsüberblick: Was sehen Kunde und Betreuung?
Bei PoloProfi gibt es zwei Dashboards. Das technische Dashboard hilft mir, Auslastung, Antwortzeiten und Fehler einzuordnen. Es zeigt Kennzahlen zu Containern, Datenbank, Redis als Zwischenspeicher und der Auslieferung von Inhalten.
Das zweite Dashboard fasst den Shop-Betrieb und geschäftliche Ereignisse zusammen:
- Anzahl der Shop-Aufrufe und Fehlerquoten
- Antwortzeit: 95 Prozent der gemessenen Anfragen sind schneller als dieser Wert
- Anzahl laufender Web-Instanzen
- Bestellungen pro Stunde
- Erfasste Zahlungsstatus, etwa bezahlt oder fehlgeschlagen
Die Anzahl laufender Web-Instanzen zeigt die bereitgestellte Kapazität, nicht die Erreichbarkeit von außen. Die Antwortzeit einer Anfrage ist außerdem nicht die vollständige Ladezeit einer Seite im Browser. Die Erfassung von Zahlungsstatus gehört zur Monitoring-Erweiterung. Bei neuen Shops richte ich sie von Anfang an passend zu den eingesetzten Zahlungsarten ein. Sobald Zahlungen verarbeitet werden, fließen die erfassten Statuswechsel ins Dashboard ein.
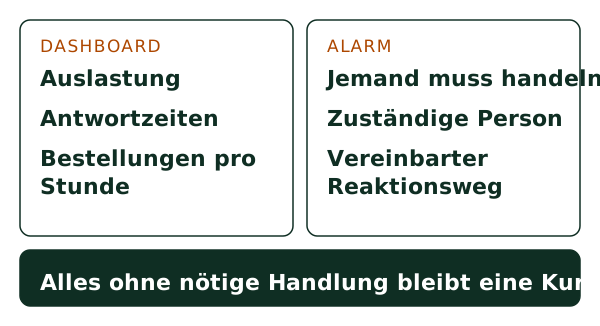
Der Kunde erhält Zugriff auf beide Dashboards. So können wir Auffälligkeiten anhand derselben Daten besprechen. Welche Kennzahlen wichtig sind, hängt vom jeweiligen Shop ab. Nicht jede Abweichung braucht einen Alarm, aber jeder Alarm braucht eine zuständige Person und einen vereinbarten Reaktionsweg. E-Mail-Meldungen allein sind keine Rufbereitschaft.
Der technische Rahmen
PoloProfi läuft in einem eigenen AWS-Account in der Region Frankfurt. Shopware und die Hintergrundverarbeitung laufen in Containern auf Amazon Elastic Container Service, kurz ECS. Container sind abgegrenzte Laufzeitumgebungen für die Anwendung. Der Webdienst kann innerhalb festgelegter Grenzen zusätzliche Instanzen starten. Für die Überwachung zählt deshalb nicht nur die Auslastung eines einzelnen Containers, sondern das Zusammenspiel von Antwortzeiten, Fehlern und verfügbarer Kapazität.
Sechs Alarme, die eine Handlung auslösen
Ich habe vor einiger Zeit beschrieben, wie ich Monitoring mit Signal statt Rauschen aufsetze. Bei PoloProfi bedeutet das:
Mein Grundsatz: Ein Alarm kommt nur, wenn jemand etwas tun muss. Alles andere gehört ins Dashboard. Für den Shop sind diese sechs technischen Alarme eingerichtet. Die Tabelle zeigt ihren Zweck. Die konkreten Schwellen und Zeitfenster müssen zur jeweiligen Umgebung passen:
| Alarm | Worauf er hinweist | Was ich zuerst prüfe |
|---|---|---|
| Fehler in der Anwendung | Serverfehler bei der Verarbeitung von Anfragen | Fehlermeldungen und betroffene Vorgänge in Sentry |
| Fehler am Load Balancer, dem Verteiler der Anfragen | Fehler vor oder bei der Weiterleitung an die Anwendung | Zustände und Antworten der Container |
| Kein gesunder Web-Container | Kein Web-Container besteht die konfigurierte Zustandsprüfung | Container und Ergebnis der Zustandsprüfung |
| Datenbank-Speicher | Der freie Speicher wird knapp | Speicherwachstum und konfigurierte Erweiterungsgrenzen |
| Datenbank-Last | Die gemessene Auslastung bleibt erhöht | Auffällige Abfragen und verfügbare Rechenleistung |
| Redis-Speicher | Der Zwischenspeicher nähert sich seiner Kapazitätsgrenze | Speicherverbrauch, gespeicherte Inhalte und Kapazität |
Für die WordPress-Seite gibt es entsprechende Alarme zu Anwendungsfehlern und fehlenden gesunden Web-Containern. Die Zustandsprüfung der Container ersetzt keinen externen Erreichbarkeitstest.
Für Alarm und Entwarnung sind E-Mail-Benachrichtigungen eingerichtet. Der vollständige Test vom ausgelösten Signal bis zum empfangenen Alarm steht noch aus.
Eine steigende Auslastung des Webdienstes ist dagegen zunächst eine Kurve im Dashboard: Innerhalb der konfigurierten Grenzen kann zusätzliche Kapazität automatisch bereitgestellt werden. Das löst keine Engpässe in Datenbank oder Schnittstellen. Deshalb betrachte ich Antwortzeiten, Fehler und Auslastung gemeinsam.
Bestellungen sind kein AWS-Signal, also mache ich eins daraus
Die Infrastrukturüberwachung erfasst Anfragen, Fehlercodes und Antwortzeiten. Eine erfolgreich angelegte Bestellung erkennt sie nicht automatisch. Dafür braucht es ein Signal aus der Anwendung. Bei jeder Bestellung schreibt der Shop eine kurze Zeile ins Log: Bestellnummer, Betrag, Währung, Zahlart und Anzahl der Positionen. Dasselbe passiert, wenn sich der Status einer Zahlung ändert, etwa von offen auf bezahlt. Namen, Anschriften und vollständige Zahlungsdaten gehören nicht in diese Ereignisse. Bestellnummern können trotzdem einen Personenbezug ermöglichen. Zugriffsrechte, notwendiger Umfang und Aufbewahrung der Protokolle müssen deshalb berücksichtigt werden.
Aus diesen Zeilen macht CloudWatch, der AWS-Dienst für Messwerte und Protokolle, vier Kennzahlen: Bestellungen, Bestellwert, bezahlte und fehlgeschlagene Zahlungen. Im Shop selbst ist das ein kleines Event, in der Infrastruktur sind es vier Filter und ein paar Kacheln. Bei PoloProfi erfasst ein eigenes Plugin diese Ereignisse. Die Plugins sind nicht öffentlich erhältlich. Einrichtung, Betrieb und Pflege sind Teil unserer vereinbarten Leistungen. Für weitere Shops muss die Erfassung zu den jeweiligen Abläufen passen.
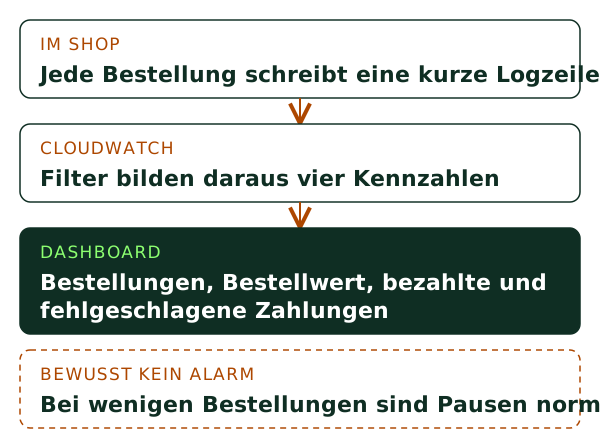
Einen Alarm habe ich darauf bewusst nicht gesetzt. Bei wenigen Bestellungen am Tag können vier Stunden ohne Auftrag zum normalen Geschäftsverlauf gehören. Daraus allein lässt sich keine Störung ableiten. Die Kurve gehört ins Dashboard. Bei ausreichenden Daten können Vergleiche mit ähnlichen Wochentagen oder eine automatische Erkennung ungewöhnlicher Werte helfen. Ob daraus ein brauchbarer Alarm entsteht, muss anhand des Shops geprüft werden. Wenige Bestellungen allein belegen noch keine technische Störung.
Fehler finden statt suchen
Das Dashboard zeigt, wie häufig Fehler auftreten. Um ihre Ursache einzugrenzen, nutze ich Sentry, ein Werkzeug zur Erfassung und Untersuchung von Anwendungsfehlern. Es ergänzt die Kennzahlen um Details zum Fehler und seinem Zusammenhang.
Der Shop meldet erfasste Anwendungsfehler mit dem für die Untersuchung benötigten Kontext an Sentry. Filter und Einstellungen bestimmen, welche Meldungen dort ankommen. Sensible Angaben müssen dabei ausgeschlossen werden. Jede Veröffentlichung wird mit ihrer Versionsnummer in Sentry markiert. So sehe ich, welche Anwendungsversion beim Fehler lief, und kann die Suche eingrenzen. Auch Fehler bei der Verarbeitung von Hintergrundaufgaben können dort ankommen. Ein still ausgebliebener geplanter Lauf wird dadurch nicht automatisch erkannt.
Zwei Beispiele aus den ersten Wochen.
Kurz nachdem der Shop online erreichbar war, lief Sentry plötzlich voll. Shopware protokolliert auch harmlose Anfragen mit fehlenden Parametern als Fehler, und jeder Crawler, der eine bestimmte Art von URL aus dem Quelltext aufgerufen hat, erzeugte damit einen eigenen Eintrag. Seitdem filtert eine kleine Regel diese Anfragen heraus, bevor sie gemeldet werden. Was jetzt bei Sentry ankommt, ist wieder etwas, das ich mir wirklich anschauen sollte.
Das zweite Beispiel: Sentry meldete Konflikte in der Warteschlange. Die Ursache war eine Shopware-Funktion, die Hintergrundaufgaben im Browser des Administrators abarbeitet. Sobald zwei Leute gleichzeitig im Admin angemeldet waren, kamen sich beide in die Quere. Weil der Shop für diese Aufgaben ohnehin einen eigenen Dienst hat, war die Lösung einfach: Funktion im Browser aus, Konflikt weg.
Genau das ist für mich Monitoring im Alltag. Keine Katastrophe, sondern zwei kleine Funde, die ich ohne Sentry nicht bemerkt hätte und nach denen der Shop jeweils ein Stück sauberer war.
Was der vorhandene Shop-Test prüft
Für die Zeit nach dem Deployment gibt es einen automatischen Test, der einmal durch den Shop geht, so wie ein Kunde: Startseite, Produkt, Warenkorb, bis zum Einstieg in den Checkout, ohne etwas zu kaufen. Der Test löst keinen Kauf aus. Er prüft weder einen vollständigen Bestellabschluss noch Zahlung oder Auftragsübernahme in ein ERP. Er ist fertig, hängt aber gerade nicht in der Pipeline. Ihn dort wieder als letzte Stufe einzubauen, steht auf meiner Liste.
Die Logs aller Container bleiben 30 Tage. Das ist die hier gewählte Aufbewahrungszeit. Welche Inhalte protokolliert werden und wer darauf zugreifen darf, muss zusätzlich festgelegt und geprüft werden.
Was als Nächstes ansteht
Ein paar Punkte sind noch offen, und ich nenne sie lieber, als sie wegzulassen:
- Backup und Wiederherstellung einmal komplett durchspielen. Die Datenbank wird täglich gesichert, die Sicherungen werden sieben Tage aufbewahrt. Das allein weist noch nicht nach, dass sich der gesamte Shop einschließlich benötigter Dateien und Konfigurationen wiederherstellen lässt.
- Einen Testalarm auslösen, damit die ganze Kette bis ins Postfach einmal nachweislich funktioniert hat.
- Den Test nach dem Deployment wieder als feste Stufe in die Pipeline hängen.
- Regelmäßige Aufgaben mitüberwachen, damit ein geplanter Task nicht still ausbleibt, ohne dass es jemand merkt.
Fazit
Entscheidend ist nicht die Bezeichnung des Hosting-Angebots, sondern welche Aufgaben tatsächlich übernommen werden. Für mich gehört zum Shop-Betrieb der Blick in die Anwendung, nicht nur auf die Server.
Bei PoloProfi kombiniere ich technische Messwerte, sechs Shop-Alarme, zwei Dashboards, Anwendungsereignisse und Sentry für die Fehleranalyse. Die noch offenen Prüfungen gehören zur Einordnung dieses Projektstands dazu. Die eigentliche Arbeit steckt nicht in den Tools, sondern in der Frage, welche Zahl welche Entscheidung auslösen soll.
Die als Code beschriebenen Bausteine lassen sich für weitere Shops anpassen. Welche Prüfungen, Kennzahlen und Reaktionswege nötig sind, wird für den jeweiligen Shop festgelegt. Das Projektbeispiel ist keine unveränderte Vorlage für jeden Betrieb.
Auch Monitoring verursacht Aufwand und gegebenenfalls AWS-Kosten für Protokolle, Messwerte, Dashboards und Alarme. Wie diese in die gesamte Betriebsentscheidung gehören, erkläre ich in Shopware auf AWS hosten: Betrieb und Kosten.
Wenn du wissen willst, wie das für deinen Shop aussehen würde: Auf der Seite Shop-Monitoring steht, was dazugehört, unter Betrieb und Hosting, wie der Shop drumherum läuft, und in der Paketübersicht, in welchem Rahmen wir das für dich übernehmen.